
GPUを数える前に、処理する仕事を分ける
企業AIの構成を考えるとき、「GPUは何枚必要か」という質問が出てきます。しかし、その答えは使うモデルだけでなく、入力の長さ、同時利用、回答の量、監査処理の有無などで変わります。最初に必要なのは、AIが担う仕事の整理です。
本構想では、仕事を大きく三つに分けます。一つ目は、入力情報を分類し、処理先を決めるための保護。二つ目は、文章を作成し、資料を要約する生成。三つ目は、記録を調べたり文書を横断したりする監査です。すべてを同じ処理待ちの列に入れると、一つの重い仕事が他の利用に影響する可能性があります。
そこで8GPUを想定し、処理の役割を分ける案を検討しています。これは本プランの構成例であり、IMMERSIAの全製品に共通する標準構成ではありません。実際の台数や搭載条件は、機器と業務の両面から確認します。
8GPUは、保護・生成・監査の役割へ割り当てる
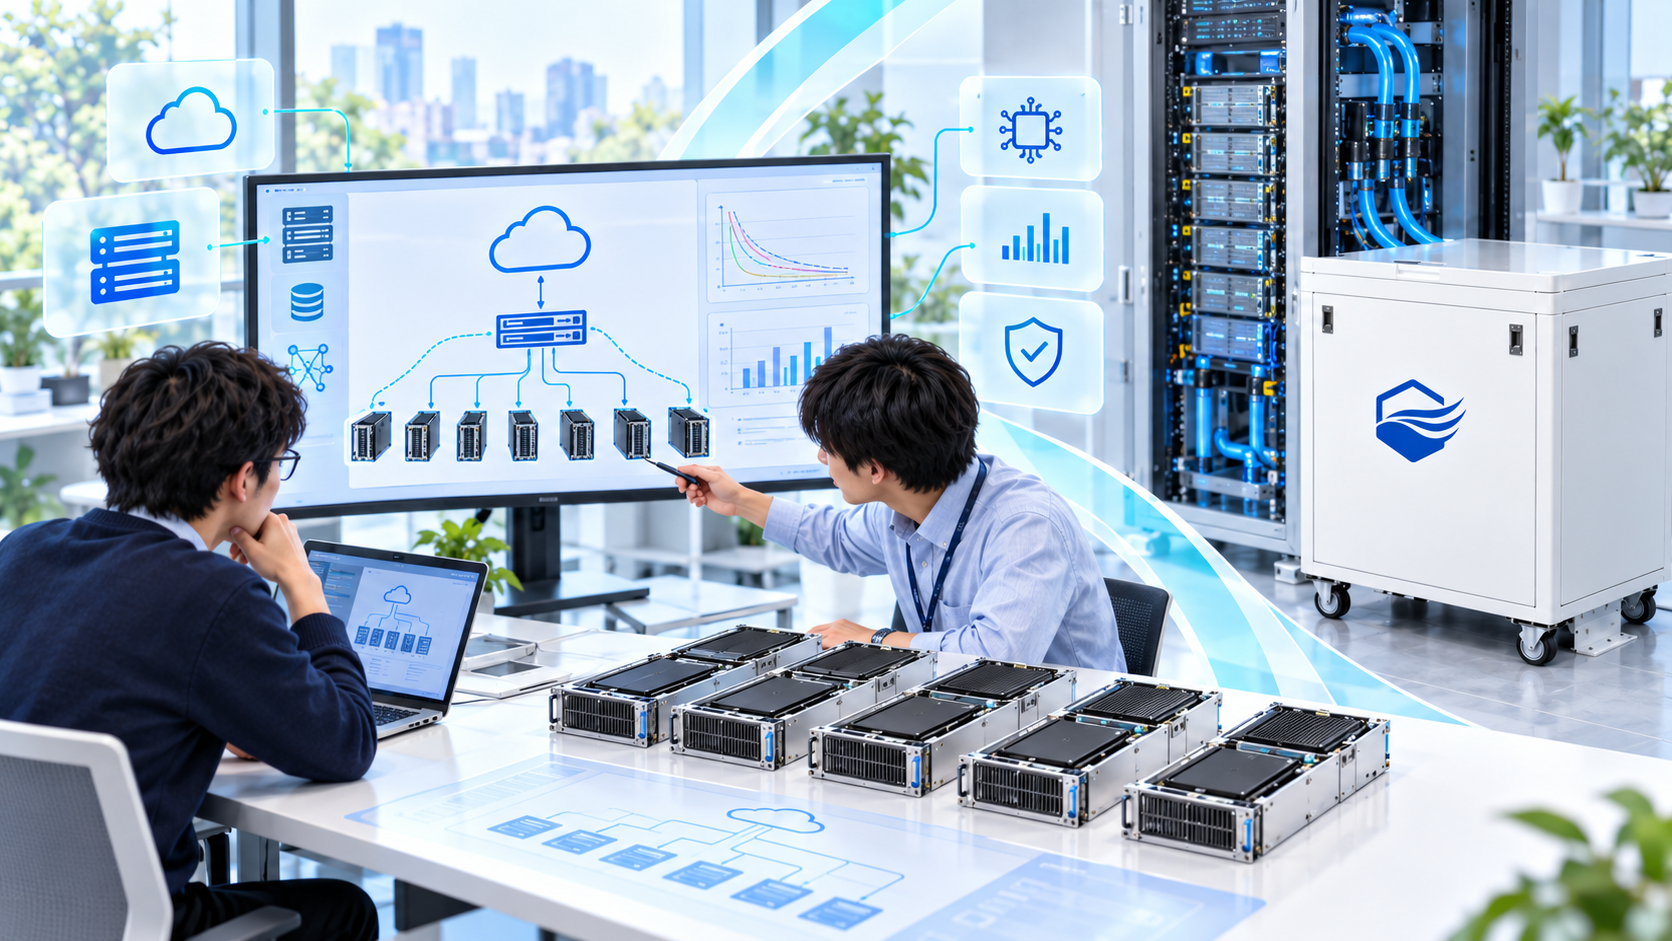
構成例では、GPU01を情報の判定処理、GPU02を比較的軽い生成処理、GPU03〜06を複数GPUで動かす生成処理、GPU07〜08を監査や検索関連の処理へ割り当てます。役割を図にすることで、日常の質問と重い監査処理がどこで競合するかを検討しやすくなります。
ただし、情報を守るDLPや認証・権限管理の機能が、すべてGPU上で動くわけではありません。CPU、メモリ、ストレージ、ネットワーク、管理用ソフトウェアも必要です。「GPU01があるから送信制御が完成する」と理解しないことが大切です。
また、GPUを分けただけで厳密なセキュリティ隔離が保証されるわけでもありません。プロセス、コンテナー、ネットワーク、保存先、権限の分離なども合わせて設計します。用途によっては、別のサーバーへ分ける方が適切な場合もあります。
モデルを載せられることと、快適に使えることは違う
モデルをGPUメモリに収められても、多くの社員が同時に長文を入力したときの快適さは別に確かめる必要があります。モデルの重み以外にも、推論中のデータや会話に応じた情報を保持する領域が必要になるためです。
複数GPUのメモリ容量を合計した数字も、あらゆるモデルが自由に使える一つの領域を意味しません。モデルを分散して動かす方式、GPU間通信、ソフトウェアの対応、量子化などの条件によって、実際の動作が変わります。
検証では、短い質問への返答だけでなく、長い契約書の要約、複数資料の比較、会話が続いた状態も試します。最初の文字が出るまでの時間、回答全体が終わるまでの時間、混雑時の待ち時間を分けて測ると、どこに負担があるかを把握しやすくなります。
利用人数から、まず到着する処理の数を見積もる
例えば、社員1,000人が1日10回、8時間の間にAIを使うと仮定すると、全体で1日10,000件です。その10%が社内AIへ回るなら、社内処理は1日1,000件。平均では毎秒約0.035件になり、平均の10倍が集中する時間帯を想定すると毎秒約0.35件です。
これは「何件の依頼が到着するか」という需要の試算です。AIがその速度で回答を完了できることや、待ち時間が発生しないことを示す性能値ではありません。同じ1件でも、数行の質問と数十ページの文書では必要な処理が違います。
利用人数を増やした表を見るときも、この前提を一緒に確認してください。外部へ回せる割合が変われば社内の負荷は変わります。朝の始業時や会議前など、利用が集中する業務時間も考慮し、実際の依頼に近い条件で計測します。
| 社員数 | 1日の依頼数(全体) | 社内処理10% | 平均(件/秒) | ピーク×10(件/秒) |
|---|---|---|---|---|
| 500人 | 5,000件 | 500件 | 約0.017 | 約0.17 |
| 1,000人 | 10,000件 | 1,000件 | 約0.035 | 約0.35 |
| 2,000人 | 20,000件 | 2,000件 | 約0.069 | 約0.69 |
| 5,000人 | 50,000件 | 5,000件 | 約0.174 | 約1.74 |
1人10回/日、8時間、社内処理10%、ピーク10倍という仮定による到着件数。処理性能の保証値ではありません。
液浸冷却は、熱と設置条件の検討につながる
GPUを高密度に搭載する構成では、計算性能と同時に熱をどう処理するかが課題になります。液浸冷却では、適合する冷却液に機器を浸し、機器から液へ移った熱を、循環や熱交換の仕組みで取り除きます。
冷却方式の選定では、想定する発熱、機器と冷却液の適合、保守方法、電源、床荷重、搬入経路、漏えい時の対応などを確認します。装置の外へ放出される熱をどう扱うかも必要です。液浸にすれば建物側の換気や空調の検討が一律に不要になるわけではありません。
WOODMANの構想では、GPUを動かすソフトウェア側の計画と、液浸設備側の条件を合わせて確認します。冷却能力の数値だけでAIの利用人数は決められず、逆にAIの性能試験だけで設置条件を決めることもできません。両方がそろって、運用可能な基盤になります。
性能表を見るときは、測った仕事をそろえる
参考資料には、判定モデルが一秒間に処理した件数や、特定のGPUで測った速度が示されることがあります。しかし、短い入力を分類する試験と、長文を読み取って回答を生成する試験は、同じ「AIの速さ」でも内容が異なります。前者の件数を、そのまま全社員が使える人数へ換算することはできません。
比較するときは、GPUとメモリ、モデルと設定、入力・出力の長さ、同時実行数、測定対象の範囲をそろえます。検索の時間を含めるか、待ち行列の時間を含めるかによっても、利用者が感じる速さとの関係が変わります。条件が分からない数値は、導入判断の決め手にせず、追加検証の手掛かりとして扱います。
また、生成処理と監査処理を同時に動かす試験も必要です。単独では速くても、検索用データの読み込みや共有資源の競合で遅くなる可能性があります。日中は社員の利用を優先し、重いバッチを別の時間帯へ回すなど、設備の追加以外の調整も考えられます。
モデルを小さくする、回答を短くする、参照文書を絞るという工夫には、品質への影響があります。速度だけを改善して、業務に必要な根拠や説明が失われないかも確認します。性能と品質の両方を、同じ業務のテストで追うことが大切です。
最終的には、候補の構成で代表的な作業を動かし、待ち時間と回答品質を見ます。仕様表だけで決めず、実際に使う条件を設備選定へ戻すことで、必要な余力の根拠を説明しやすくなります。
余力は、無駄ではなく設計するもの
8GPUを搭載する目的は、すべてを常に100%動かすことではありません。利用が集中したときの余裕や、監査処理を別枠で動かすための分離を確保する考え方があります。ただし、空いているGPUがあれば自動的に障害を引き継げるわけではなく、切り替えの仕組みは別途必要です。
導入前には、必要な応答時間と利用のピークを決め、通常時、混雑時、保守時にどう動かすかを試します。CPUや検索用ストレージが先に限界になることもあるため、GPUだけでなくシステム全体を観察します。
機器の大きさを先に決めるのではなく、仕事の量と品質から必要な構成へ近づける。それが、過不足のないAI基盤を作るための進め方です。次回は、この基盤で考えられる社内業務・会計・医療の用途を具体的に見ていきます。