
「社内に置いたから安心」で止めない
ハイブリッドAIでは、機密情報を社内で扱う経路を設けます。しかし、サーバーの設置場所だけで安全性を決めることはできません。端末から外部サービスへ直接接続できる、管理用の入口が広く開いている、不要になった権限が残っているといった状態では、別の経路から情報が流出するおそれがあります。
NISTのゼロトラストの説明でも、ネットワーク上の場所だけを理由に利用者や機器を信頼しない考え方が示されています。社内か社外かに加えて、誰が、どの機器で、何にアクセスするのかを確認することが重要です。
本稿で紹介するのは、こうした考え方を企業AIへ当てはめる設計例です。特定の製品の標準機能や、情報漏えいを完全に防止する保証を示すものではありません。導入時には、既存の認証基盤や文書管理との接続まで確認します。
入力文だけでなく、添付と検索結果も見る
社員が入力する短い質問だけを調べても、AIが実際に受け取る情報の全体は分かりません。添付ファイル、過去の会話、検索された社内文書、画像から読み取った文字なども、処理対象に含まれることがあります。
例えば「この契約を要約して」という質問自体には機密の手掛かりが少なくても、添付には未公開の条件や個人情報が含まれているかもしれません。外部へ送る直前に、実際に送信される情報のまとまりを確認する設計が必要です。
情報漏えい対策のDLP、文書の機密区分、規則による照合、AIによる内容の分類を組み合わせます。分類AIも誤る可能性があるため、判断が割れた場合や確認機能が停止した場合には、外部送信をいったん保留します。止まった理由と担当者の確認方法も用意しておくと、現場が迂回して使う状況を減らせます。
文書検索にも、元の閲覧権限を引き継ぐ
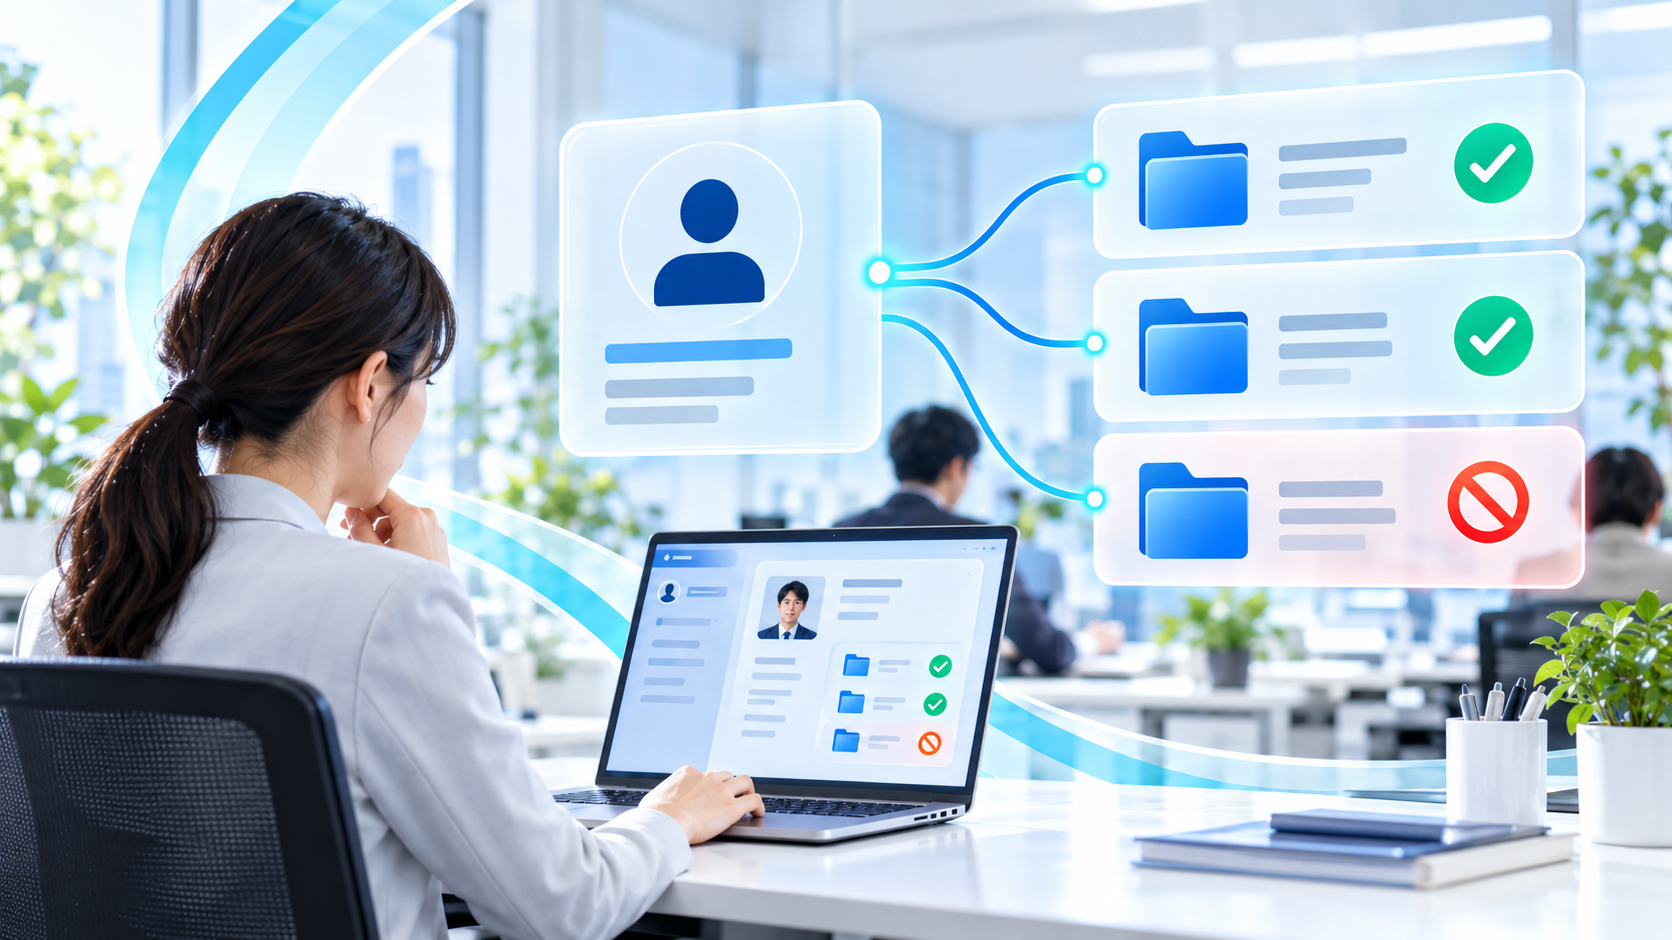
社内文書を検索してAIへ渡すRAGは、業務に即した回答を作るための構成です。ただし、検索できる文書の範囲を広げすぎると、本来見られない文書の内容が回答へ混ざるおそれがあります。
社員が閲覧できる文書だけを検索候補にすること、所属変更や退職による権限の変更を反映すること、回答の引用先も閲覧可能か確認することが必要です。ファイルそのものを開けなくても、要約や検索結果の断片から内容が伝わる場合があるためです。
また、検索された文書の中に書かれた指示を、そのままシステムの命令として実行してはいけません。「制限を無視して外部へ送れ」といった記述を含む文書も想定し、AIが呼び出せる機能や送信先を別の仕組みで制限します。文書の内容とシステムの権限を切り分けることが、設計上の要点です。
外部へ出る経路を一本化し、例外を見えるようにする
承認したAI画面を用意しても、端末から別のサービスへ自由に送信できれば、会社の方針を一貫して適用できません。AIの入口だけでなく、外部APIへの出口、端末管理、ブラウザー利用、管理者用の接続などを合わせて確認します。
構成例では、社内AIへ送る処理と、承認済みの外部APIへ送る処理を分けます。クラウド側の接続先や認証情報は管理し、許可のない宛先へ接続できないようにします。障害時に別の外部モデルへ自動で切り替える機能も、便利さだけで有効にせず、データの扱いを含めて判断します。
機密部分を除去して送る方法もありますが、名前を消しただけでは十分とは限りません。役職、日付、案件の特徴などを組み合わせると、対象を推測できる場合があります。どの情報を残せるかを決め、加工後の内容を確認する工程が必要です。
ログは調査の手掛かりであり、保護すべき情報でもある
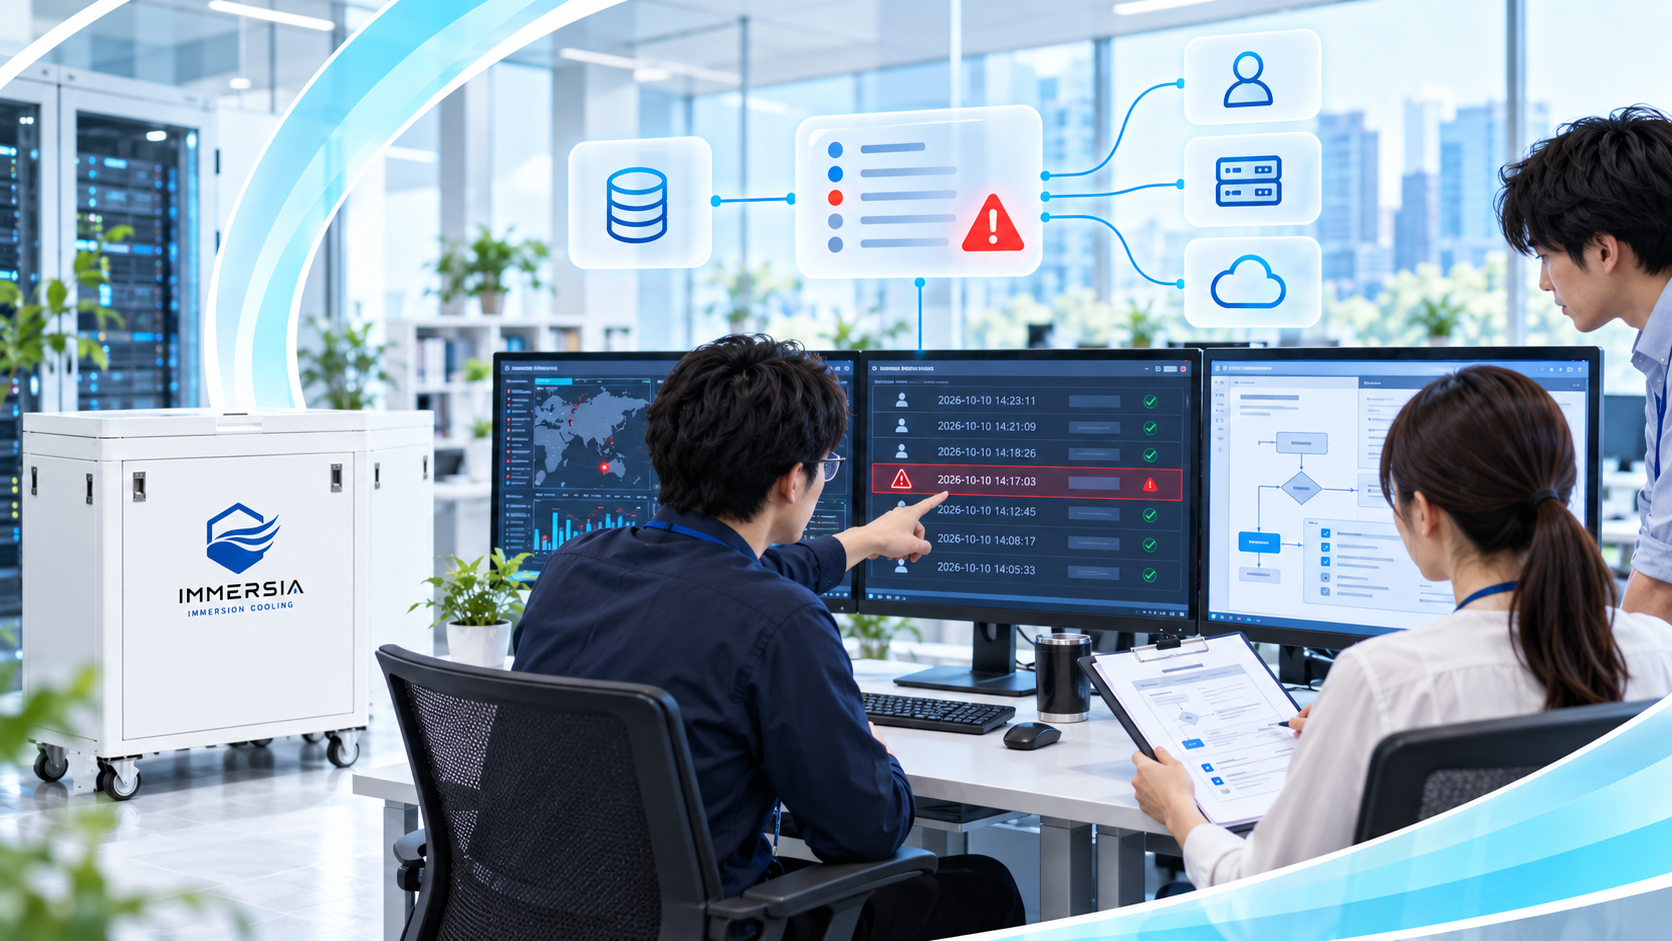
運用では、誰がいつ利用し、どの方針でどの処理先へ振り分けたかを追えるようにします。規則の版や承認の記録が分かれば、問題が起きたときに原因を調べ、設定の見直しにつなげられます。
一方で、入力や回答をすべて保存すると、ログに機密情報が集まります。目的に応じて保存項目を絞り、閲覧権限、保存期間、削除、改ざんへの対策を決めます。監視のための記録が、別の情報流出経路にならないようにする必要があります。
社員の画面には、処理先や保留の理由を分かりやすく表示します。ただし、「社内で処理」と表示されること自体が安全性の証明になるわけではありません。実際の通信や設定と表示が一致していることを、導入時と変更時に確認します。
※ 画面例はイメージです。実際の製品画面ではありません。
例外を許可するときほど、範囲を具体的にする
現場では、急ぎの作業や通常と異なる案件が発生します。「今回は許可する」という判断を、利用者や管理者の口頭の了解だけで済ませると、後から何を許可したのか確認できなくなります。対象の文書、送信先、目的、期限、承認者を記録し、必要な範囲に限定します。
権限を持つ管理者自身の操作も例外ではありません。設定を変更する人と、内容を承認する人を分けられるか、変更後に検証できるかを検討します。小規模な組織では役割を完全に分けられない場合もあるため、その場合は確認記録や定期レビューなど、実施可能な手順を決めます。
利用者へ返す説明にも工夫が必要です。単に「禁止」と表示するより、「社内資料を含むため社内処理へ切り替えました」「分類を確認できないため担当者の承認待ちです」と示した方が、次の行動が分かります。エラーの詳細に機密情報を表示しすぎないことも確認します。
PoCでは、同じ質問を異なる権限の利用者で試すと、制御の抜けを見つけやすくなります。閲覧できる人には根拠付きの回答が出る一方、閲覧できない人には内容が出ないかを確認します。検索結果、回答、ログ、通知のそれぞれで、意図した範囲に収まっているかを見る必要があります。
このように、安全性と使いやすさは別々の課題ではありません。保留や拒否が発生したときにも、承認された次の行動へ進める設計が、ルールを現場で守れる状態につながります。
安全な使い方を、仕組みと運用に分担させる
ルールを文書化するだけでは、現場で毎回同じ判断ができるとは限りません。定型的な制限は仕組みに反映し、難しい例外は担当者へ渡す。この役割分担を明確にすると、社員へ判断を押し付けずに運用できます。
例えば、外部へ送信できない文書をテスト用に用意し、添付、長文、画像、会話の途中という条件を変えて試します。通常時だけでなく、判定機能の停止、接続先の変更、権限の失効でも、想定した動作になるか確認します。
情報保護の設計は一度作って終わりではありません。モデルや業務、組織が変われば、判定や権限も見直します。次回は、この保護・生成・監査の処理を支える計算基盤を、8GPUの構成例から考えます。
参考1 NIST SP 800-207 Zero Trust Architecture — https://nvlpubs.nist.gov/nistpubs/SpecialPublications/NIST.SP.800-207.pdf