
在数GPU之前,先划分要处理的工作
在规划企业AI配置时,"需要多少块GPU"的问题自然会出现。但答案不仅取决于模型,还取决于输入长度、并发使用量、回答量以及是否包含审计处理。首先需要梳理AI承担的工作内容。
本构想将工作大致分为三类:一是对输入信息进行分类并决定处理目标的"保护";二是生成文章和摘要资料的"生成";三是查阅记录或跨文档检索的"审计"。将所有任务放入同一处理队列,可能导致一项繁重任务影响其他用户的使用。
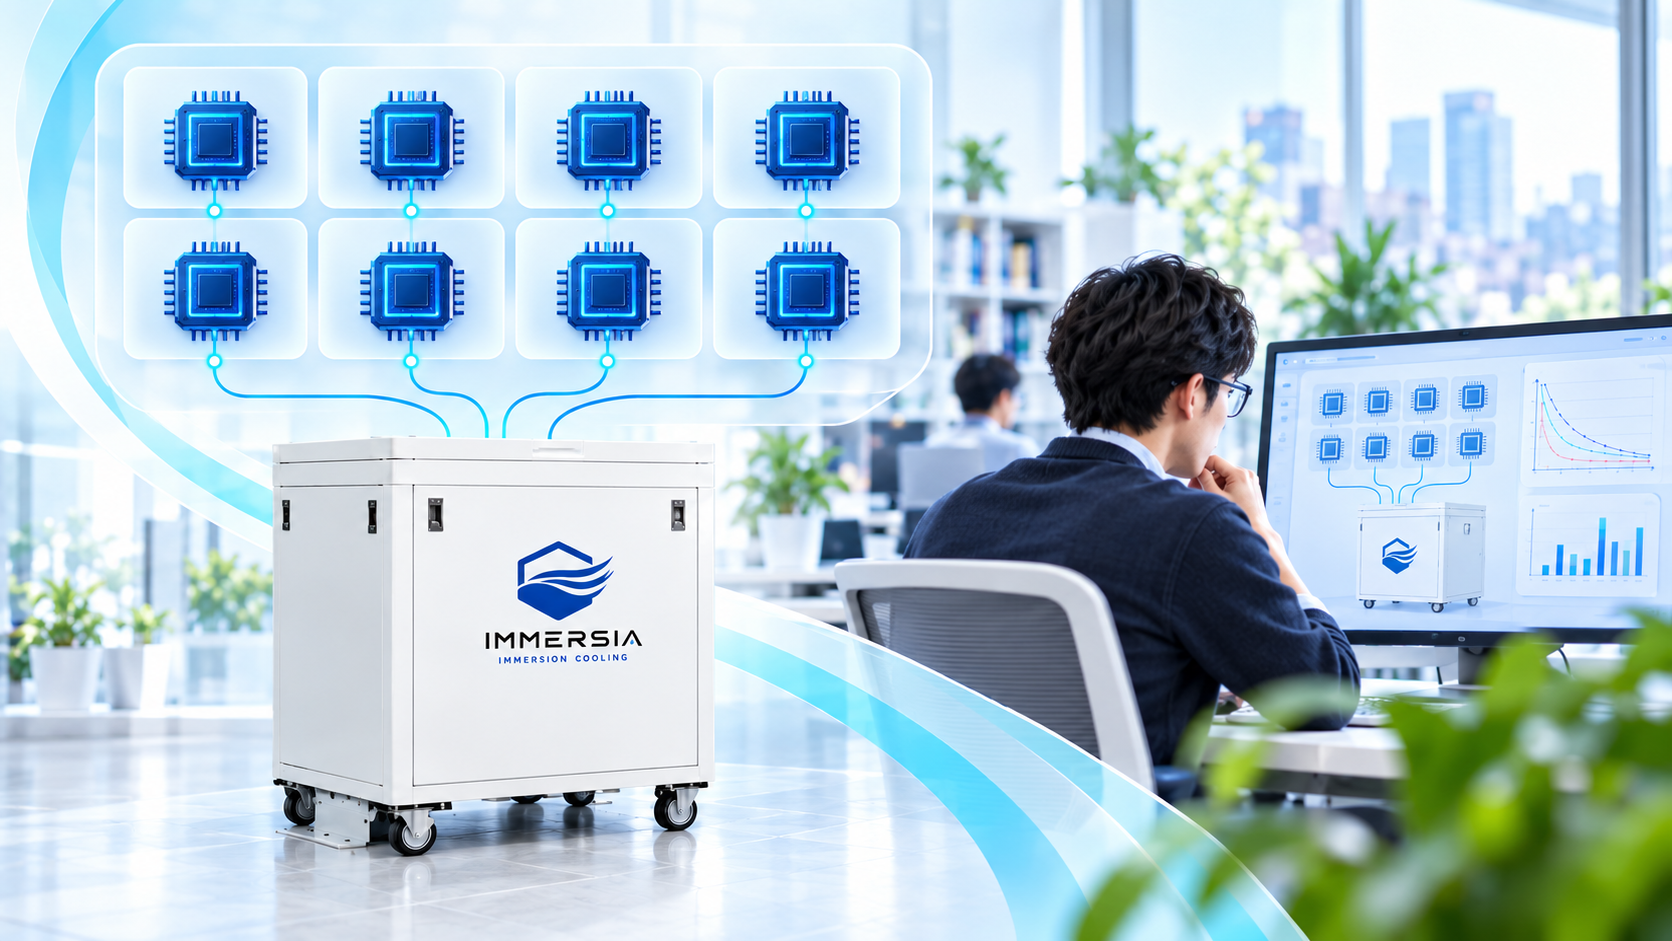
因此,我们正在探讨以8块GPU为前提、按角色分配处理的方案。这是本方案的配置示例,并非IMMERSIA所有产品通用的标准配置。实际数量和安装条件需从设备和业务两个维度确认。
将8块GPU分配给保护、生成和审计角色
示例配置中,GPU01负责信息判定处理,GPU02负责相对轻量的生成处理,GPU03至06负责跨多块GPU运行的生成处理,GPU07至08负责审计和检索相关处理。通过图示角色分配,更容易评估日常问答与繁重审计处理在哪里产生竞争。
但DLP及认证/权限管理功能并非全部运行在GPU上,还需要CPU、内存、存储、网络和管理软件。不能将"有GPU01"理解为"发送控制已完成"。
此外,仅分离GPU并不能保证严格的安全隔离,还需设计进程、容器、网络、存储和权限的分离。根据用途,分离到不同服务器可能更为合适。
保护(GPU01)
输入信息分类和处理目标判定。DLP和认证需与CPU及软件侧协同。
生成(GPU02–06)
文章生成和资料摘要。轻量和重量任务分别分配。
审计(GPU07–08)
记录查阅和跨文档检索。可考虑与白天使用时段错开运行。
能加载模型与能舒适使用是两回事
即便模型能放入GPU显存,当大量员工同时输入长文本时的舒适度仍需单独验证。除模型权重外,推理过程中的数据和对话上下文也需要占用空间。
多块GPU显存容量的总和,并不意味着所有模型都能自由使用的单一内存池。实际行为因模型分布式运行方式、GPU间通信、软件支持和量化等条件而异。
验证时不仅要测试简短问题的回答,还要测试长合同摘要、多文档对比和持续对话状态。分别测量首字符出现时间、完整回答时间和高峰期等待时间,更容易定位瓶颈所在。
从用户数量出发,先估算到达的请求数量
例如,假设1000名员工每天使用AI 10次,分布在8小时内,则全天共10000件请求。其中10%路由到本地AI,则本地处理为每天1000件,平均每秒约0.035件,假设高峰期为平均的10倍,则约为每秒0.35件。
这是"到达多少请求"的需求估算,并非表示AI能以该速度完成回答或不会产生等待时间的性能值。即便同样是1件,数行问题与数十页文档所需的处理量截然不同。
查看用户数量增加的表格时,请同时确认这些前提条件。可外发比例变化会影响本地负荷。还需考虑早晨上班或会议前等使用集中的时段,在接近实际请求的条件下进行测量。
| 员工数 | 每日请求数(合计) | 本地处理10% | 平均(件/秒) | 高峰×10(件/秒) |
|---|---|---|---|---|
| 500人 | 5,000件 | 500件 | 约0.017 | 约0.17 |
| 1,000人 | 10,000件 | 1,000件 | 约0.035 | 约0.35 |
| 2,000人 | 20,000件 | 2,000件 | 约0.069 | 约0.69 |
| 5,000人 | 50,000件 | 5,000件 | 约0.174 | 约1.74 |
基于每人每天10次、8小时、本地处理10%、高峰10倍的假设计算的到达件数。并非处理性能保证值。
液浸冷却与散热及安装条件的规划相关
在高密度GPU配置中,散热管理与计算性能同等重要。液浸冷却将设备浸入适配冷却液,通过循环和热交换机制将设备传导至液体的热量排出。
选择冷却方式时,需确认预期发热量、设备与冷却液的适配性、维护方式、电源、地板承重、搬入路线和泄漏应对措施。如何处理装置向外排放的热量也是必要考量。液浸冷却并不意味着一律无需考虑建筑侧的通风或空调。
在WOODMAN的构想中,GPU运行的软件侧规划与液浸设备侧条件需同步确认。仅凭冷却能力数值无法决定AI用户数量,反之,仅凭AI性能测试也无法确定安装条件。两者齐备,才能构成可运营的基础设施。
查看性能表时,对齐所测量的工作内容
参考资料中可能显示判定模型每秒处理的件数或特定GPU上测得的速度。但对短输入进行分类的测试与读取长文本生成回答的测试,即便都称为"AI速度",内容也不同。前者的件数不能直接换算为全体员工可使用的人数。
比较时需对齐GPU和内存、模型和设置、输入/输出长度、并发执行数和测量范围。是否包含检索时间、是否包含队列等待时间,也会影响与用户感知速度的关系。条件不明的数值不应作为导入判断的决定性依据,而应作为追加验证的线索。
同时运行生成处理和审计处理的测试也是必要的。单独运行时速度可能很快,但加载检索数据或共享资源竞争可能导致速度下降。白天优先保障员工使用,将繁重批处理安排在其他时段,是不增加设备的调整方案之一。
缩小模型、缩短回答、缩小参考文档范围等优化措施都会影响质量。需确认在提升速度的同时,业务所需的依据和说明不会丢失。在同一业务测试中同时追踪性能和质量非常重要。
最终,需在候选配置上运行代表性任务,观察等待时间和回答质量。不仅依赖规格表做决定,将实际使用条件反馈到设备选型中,更容易说明所需余量的依据。
余量是设计出来的,不是浪费
搭载8块GPU的目的不是让所有GPU始终以100%运行。其理念是在使用集中时保留余量,并为审计处理单独分配运行空间。但有空闲GPU并不意味着能自动接管故障,切换机制需另行设计。
导入前,需确定所需响应时间和使用高峰,并测试正常、高峰和维护状态下的运行情况。CPU和检索存储可能先达到极限,因此需观察整个系统,而非仅关注GPU。
不是先决定设备规模,而是从工作量和质量出发逐步接近所需配置——这才是构建恰到好处的AI基础设施的推进方式。下一篇将具体探讨这一基础设施在内部业务、会计和医疗领域的应用构想。