
在數GPU之前,先劃分要處理的工作
在規劃企業AI配置時,「需要多少塊GPU」的問題自然會出現。但答案不僅取決於模型,還取決於輸入長度、並發使用量、回答量以及是否包含審計處理。首先需要梳理AI承擔的工作內容。
本構想將工作大致分為三類:一是對輸入資訊進行分類並決定處理目標的「保護」;二是生成文章和摘要資料的「生成」;三是查閱記錄或跨文件檢索的「審計」。將所有任務放入同一處理佇列,可能導致一項繁重任務影響其他使用者的使用。
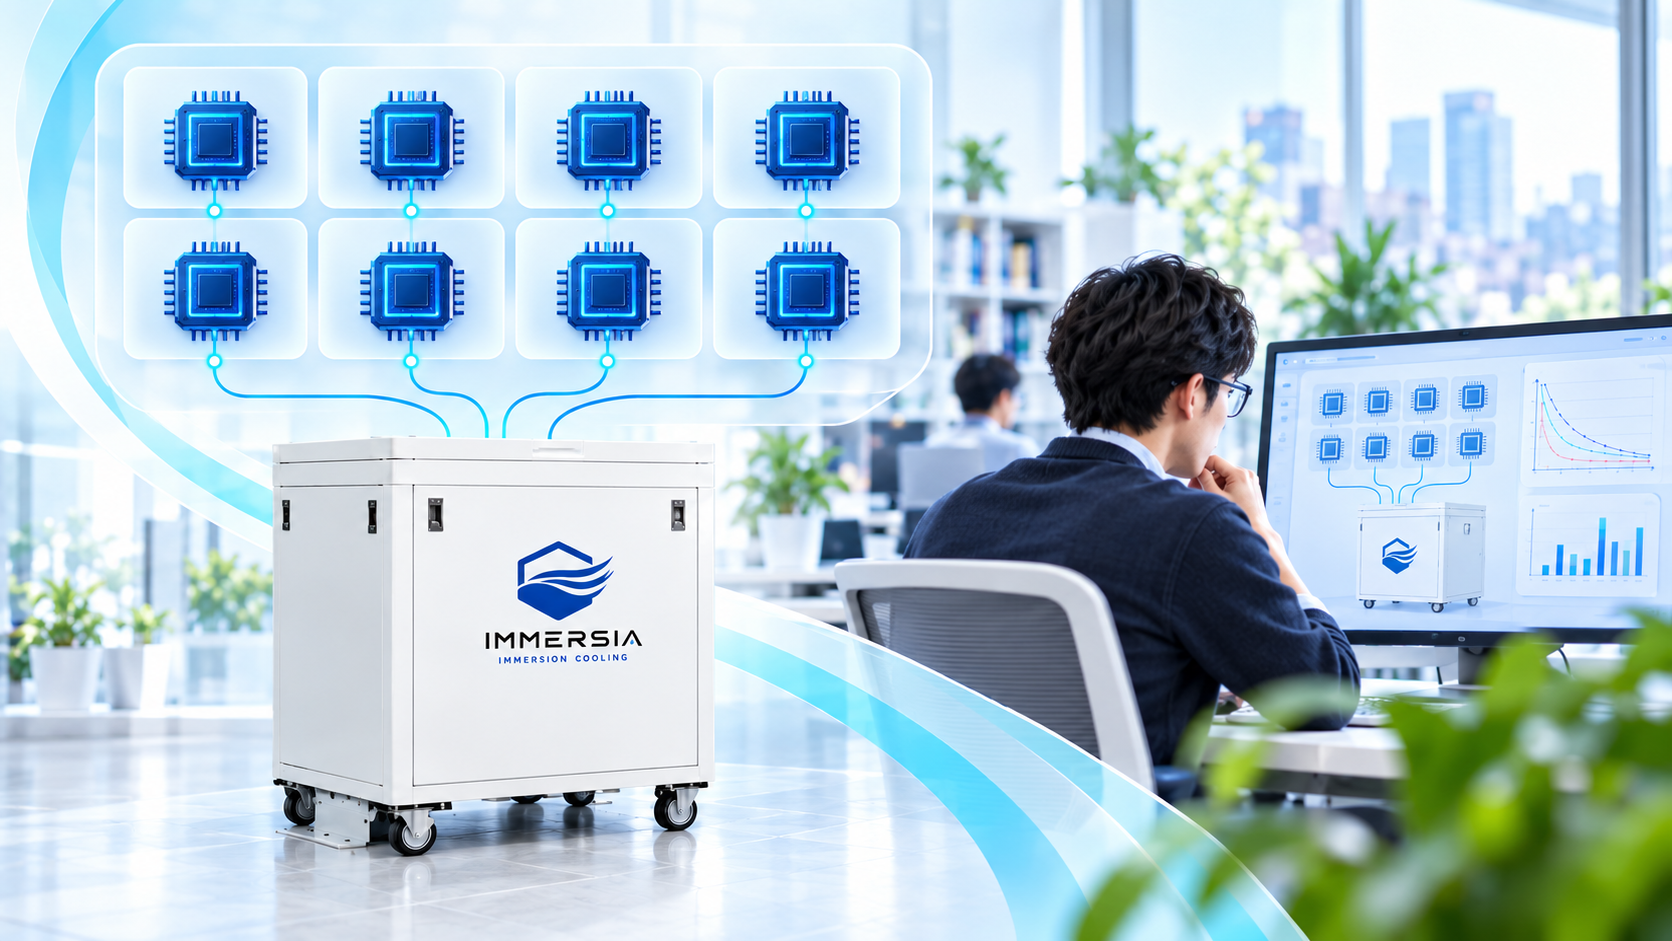
因此,我們正在探討以8塊GPU為前提、按角色分配處理的方案。這是本方案的配置示例,並非IMMERSIA所有產品通用的標準配置。實際數量和安裝條件需從設備和業務兩個維度確認。
將8塊GPU分配給保護、生成和審計角色
示例配置中,GPU01負責資訊判定處理,GPU02負責相對輕量的生成處理,GPU03至06負責跨多塊GPU運行的生成處理,GPU07至08負責審計和檢索相關處理。透過圖示角色分配,更容易評估日常問答與繁重審計處理在哪裡產生競爭。
但DLP及認證/權限管理功能並非全部運行在GPU上,還需要CPU、記憶體、儲存、網路和管理軟體。不能將「有GPU01」理解為「發送控制已完成」。
此外,僅分離GPU並不能保證嚴格的安全隔離,還需設計程序、容器、網路、儲存和權限的分離。根據用途,分離到不同伺服器可能更為合適。
保護(GPU01)
輸入資訊分類和處理目標判定。DLP和認證需與CPU及軟體側協同。
生成(GPU02–06)
文章生成和資料摘要。輕量和重量任務分別分配。
審計(GPU07–08)
記錄查閱和跨文件檢索。可考慮與白天使用時段錯開運行。
能載入模型與能舒適使用是兩回事
即便模型能放入GPU顯存,當大量員工同時輸入長文本時的舒適度仍需單獨驗證。除模型權重外,推理過程中的資料和對話上下文也需要佔用空間。
多塊GPU顯存容量的總和,並不意味著所有模型都能自由使用的單一記憶體池。實際行為因模型分散式運行方式、GPU間通訊、軟體支援和量化等條件而異。
驗證時不僅要測試簡短問題的回答,還要測試長合約摘要、多文件對比和持續對話狀態。分別測量首字符出現時間、完整回答時間和高峰期等待時間,更容易定位瓶頸所在。
從使用者數量出發,先估算到達的請求數量
例如,假設1000名員工每天使用AI 10次,分布在8小時內,則全天共10000件請求。其中10%路由到本地AI,則本地處理為每天1000件,平均每秒約0.035件,假設高峰期為平均的10倍,則約為每秒0.35件。
這是「到達多少請求」的需求估算,並非表示AI能以該速度完成回答或不會產生等待時間的性能值。即便同樣是1件,數行問題與數十頁文件所需的處理量截然不同。
查看使用者數量增加的表格時,請同時確認這些前提條件。可外發比例變化會影響本地負荷。還需考慮早晨上班或會議前等使用集中的時段,在接近實際請求的條件下進行測量。
| 員工數 | 每日請求數(合計) | 本地處理10% | 平均(件/秒) | 高峰×10(件/秒) |
|---|---|---|---|---|
| 500人 | 5,000件 | 500件 | 約0.017 | 約0.17 |
| 1,000人 | 10,000件 | 1,000件 | 約0.035 | 約0.35 |
| 2,000人 | 20,000件 | 2,000件 | 約0.069 | 約0.69 |
| 5,000人 | 50,000件 | 5,000件 | 約0.174 | 約1.74 |
基於每人每天10次、8小時、本地處理10%、高峰10倍的假設計算的到達件數。並非處理性能保證值。
液浸冷卻與散熱及安裝條件的規劃相關
在高密度GPU配置中,散熱管理與計算性能同等重要。液浸冷卻將設備浸入適配冷卻液,透過循環和熱交換機制將設備傳導至液體的熱量排出。
選擇冷卻方式時,需確認預期發熱量、設備與冷卻液的適配性、維護方式、電源、地板承重、搬入路線和洩漏應對措施。如何處理裝置向外排放的熱量也是必要考量。液浸冷卻並不意味著一律無需考慮建築側的通風或空調。
在WOODMAN的構想中,GPU運行的軟體側規劃與液浸設備側條件需同步確認。僅憑冷卻能力數值無法決定AI使用者數量,反之,僅憑AI性能測試也無法確定安裝條件。兩者齊備,才能構成可運營的基礎設施。
查看性能表時,對齊所測量的工作內容
參考資料中可能顯示判定模型每秒處理的件數或特定GPU上測得的速度。但對短輸入進行分類的測試與讀取長文本生成回答的測試,即便都稱為「AI速度」,內容也不同。前者的件數不能直接換算為全體員工可使用的人數。
比較時需對齊GPU和記憶體、模型和設置、輸入/輸出長度、並發執行數和測量範圍。是否包含檢索時間、是否包含佇列等待時間,也會影響與使用者感知速度的關係。條件不明的數值不應作為導入判斷的決定性依據,而應作為追加驗證的線索。
同時運行生成處理和審計處理的測試也是必要的。單獨運行時速度可能很快,但載入檢索資料或共享資源競爭可能導致速度下降。白天優先保障員工使用,將繁重批次處理安排在其他時段,是不增加設備的調整方案之一。
縮小模型、縮短回答、縮小參考文件範圍等優化措施都會影響品質。需確認在提升速度的同時,業務所需的依據和說明不會丟失。在同一業務測試中同時追蹤性能和品質非常重要。
最終,需在候選配置上運行代表性任務,觀察等待時間和回答品質。不僅依賴規格表做決定,將實際使用條件反饋到設備選型中,更容易說明所需餘量的依據。
餘量是設計出來的,不是浪費
搭載8塊GPU的目的不是讓所有GPU始終以100%運行。其理念是在使用集中時保留餘量,並為審計處理單獨分配運行空間。但有空閒GPU並不意味著能自動接管故障,切換機制需另行設計。
導入前,需確定所需回應時間和使用高峰,並測試正常、高峰和維護狀態下的運行情況。CPU和檢索儲存可能先達到極限,因此需觀察整個系統,而非僅關注GPU。
不是先決定設備規模,而是從工作量和品質出發逐步接近所需配置——這才是構建恰到好處的AI基礎設施的推進方式。下一篇將具體探討這一基礎設施在內部業務、會計和醫療領域的應用構想。