本地LLM部署指南
在GPU伺服器上執行本地LLM
之前需要了解的事項
部署前需掌握的7個要點:原理、場景、配置與驗證。
關於使用本地LLM的諮詢越來越多。目的各異:處理無法傳送至雲端的資料、對內部文件進行檢索、在現場執行推論……
本文從本地LLM的基礎知識出發,整理了GPU配置思路、文件檢索設計、驗證方法等部署前需要掌握的7個要點。
※ 本文以IMMERSIA EDGE為例提供參考資訊。實際配置和效能因使用場景和環境而異。
01
什麼是本地LLM,為何備受關注?
本地LLM是指在不連接網際網路的情況下,在自有伺服器或PC上執行的大型語言模型。與ChatGPT等雲端AI不同,輸入資料不會傳送至外部伺服器,因此適用於處理機密資訊的業務場景。
近年來,開源LLM的效能迅速提升,在研究機構、醫療、製造業等對資料外傳有限制的環境中,已成為值得認真考慮的實用選項。
但執行本地LLM需要與模型規模相匹配的GPU顯示記憶體和運算能力。「使用哪個模型、用於什麼場景」是選型的起點,需要提前明確。
02
可以用於哪些業務場景?
本地LLM特別適合日常工作中反覆出現的知識檢索任務:內部文件的檢索與摘要、會議記錄整理、技術資料問答、程式碼補全與審查等。
在研究機構,可用於論文和實驗記錄的問答、資料分析輔助、報告草稿生成等。在醫療和製造現場,用於手冊檢索和操作確認的案例也在增加。
另一方面,高精度數值計算、即時控制、法律判斷自動化等不允許出錯的場景並不適合。將AI定位為「輔助工具、人工決策」是設計的關鍵。
03
梳理雲端與本地的差異
雲端LLM無需前期投資即可使用最新模型,但輸入資料會傳送至外部伺服器。根據服務條款和資訊安全要求,可能存在使用限制。
本地LLM的資料不離開自有環境,更易應用於高保密性業務。但伺服器的採購、安裝和維運需要自行負責。
哪種方式更合適,取決於資料性質、所需回應速度、成本和維運能力。「先用雲端試驗,機密資料再轉為本地」的分階段導入也是有效選擇。
04
GPU選型不只看數量
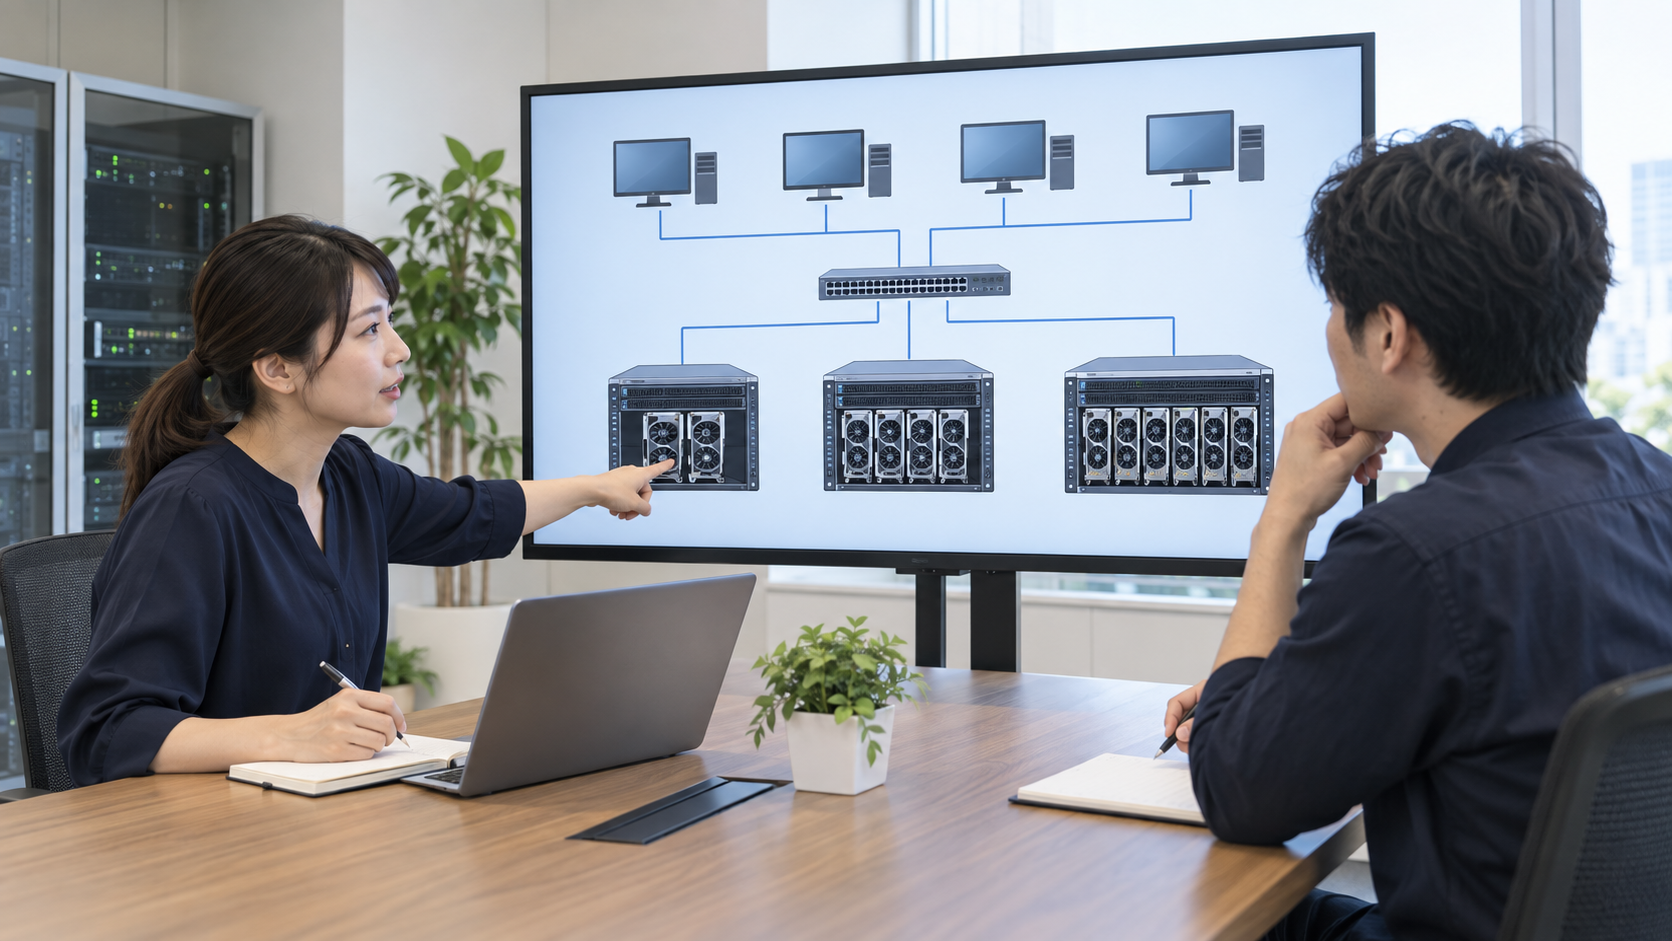
本地LLM的效能不僅取決於GPU數量,還高度依賴單卡顯示記憶體容量(VRAM)和GPU間的互連頻寬。執行大型模型需要將其分布在多張GPU上,GPU間通訊速度可能成為瓶頸。
隨著並發使用者數增加,所需顯示記憶體和運算能力也隨之增長。「單人推論」與「10人同時推論」所需的配置截然不同。
伺服器數量和互連拓撲也因使用場景而異。單台還是多台協同,取決於吞吐量、可用性和預算的平衡。建議先明確預期用途和規模,再評估合適的配置。
05
文件檢索不只依賴GPU
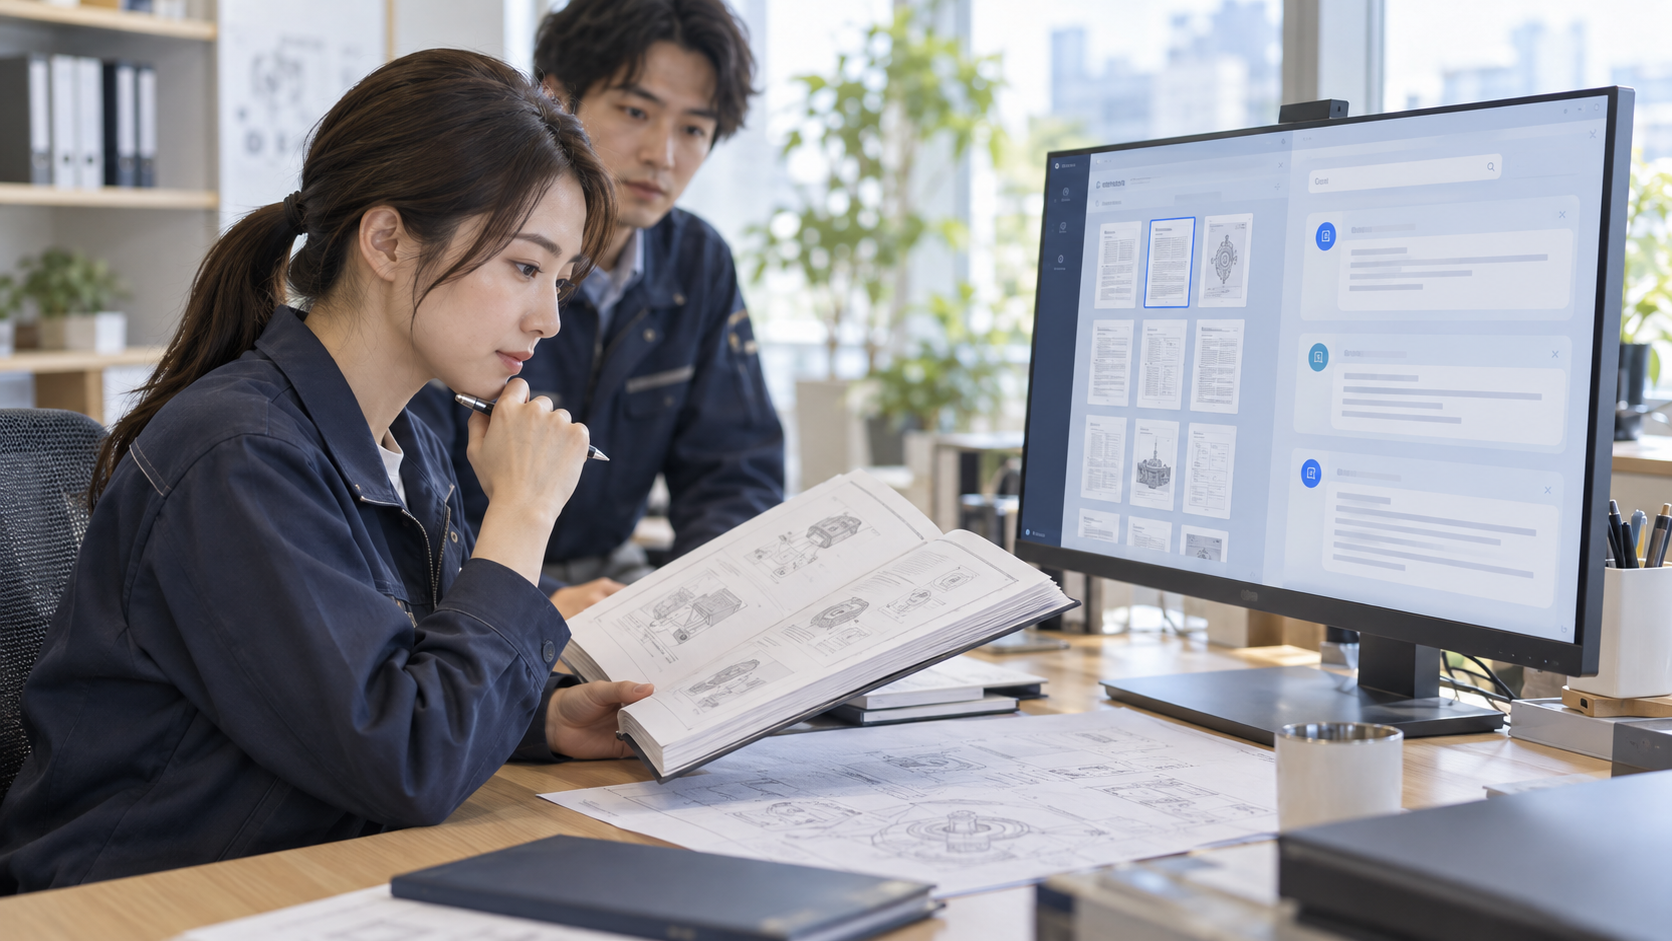
利用本地LLM對內部文件進行檢索和問答的方法稱為「RAG(檢索增強生成)」。在LLM生成回答之前,先檢索相關文件並作為上下文提供,從而得出有依據的回答。
實現RAG需要文件向量化、索引建構和檢索引擎設計。這不僅依賴GPU效能,還涉及儲存速度、CPU處理能力和軟體架構。
「增加GPU就能實現文件檢索」是過於簡化的說法。在設計整體系統之前,需要先明確文件類型、數量、更新頻率和回答品質要求。
06
本地LLM的侷限性與合理預期
對於訓練資料中不包含的最新資訊或高度專業的領域知識,本地LLM可能生成錯誤回答(幻覺)。必須設計要求人工核驗回答的營運流程。
此外,模型越大並不意味著越適合您的場景。選擇適合任務的模型並用實際業務資料進行驗證,是提高導入後滿意度的關鍵。
「導入後業務就能自動化」的期望目前過於樂觀。建議以「AI輔助、人工判斷和確認」的分工為前提來設計業務流程。
07
小規模驗證後再確定配置
導入本地LLM無需從一開始就準備大規模配置。建議先選擇1至2個典型場景,用小規模配置驗證回答品質、回應速度和易用性。
根據驗證結果確定所需GPU配置、伺服器數量、儲存和網路設計,可以減少過度投資和導入後的配置變更。
安裝條件(電源、空間、重量、散熱)需要與GPU配置同步確認。與其在配置確定後再尋找安裝場所,不如先了解安裝環境的限制條件,再縮小配置範圍,這樣能實現更順暢的導入。
本文以IMMERSIA EDGE為例提供參考資訊。內容基於公開資料,但實際效能、配置和安裝可行性因使用場景和環境而異。導入前請務必諮詢專業人員。
※ 本文圖片為AI生成的示意圖,不代表實際導入場所、員工、實物產品或已驗證的成果。