本地LLM部署指南
在GPU服务器上运行本地LLM
之前需要了解的事项
部署前需掌握的7个要点:原理、场景、配置与验证。
关于使用本地LLM的咨询越来越多。目的各异:处理无法发送到云端的数据、对内部文档进行检索、在现场运行推理……
本文从本地LLM的基础知识出发,整理了GPU配置思路、文档检索设计、验证方法等部署前需要掌握的7个要点。
※ 本文以IMMERSIA EDGE为例提供参考信息。实际配置和性能因使用场景和环境而异。
01
什么是本地LLM,为何备受关注?
本地LLM是指在不连接互联网的情况下,在自有服务器或PC上运行的大型语言模型。与ChatGPT等云端AI不同,输入数据不会发送到外部服务器,因此适用于处理机密信息的业务场景。
近年来,开源LLM的性能迅速提升,在研究机构、医疗、制造业等对数据外传有限制的环境中,已成为值得认真考虑的实用选项。
但运行本地LLM需要与模型规模相匹配的GPU显存和算力。「使用哪个模型、用于什么场景」是选型的起点,需要提前明确。
02
可以用于哪些业务场景?
本地LLM特别适合日常工作中反复出现的知识检索任务:内部文档的检索与摘要、会议记录整理、技术资料问答、代码补全与审查等。
在研究机构,可用于论文和实验记录的问答、数据分析辅助、报告草稿生成等。在医疗和制造现场,用于手册检索和操作确认的案例也在增加。
另一方面,高精度数值计算、实时控制、法律判断自动化等不允许出错的场景并不适合。将AI定位为「辅助工具、人工决策」是设计的关键。
03
梳理云端与本地的区别
云端LLM无需前期投资即可使用最新模型,但输入数据会发送到外部服务器。根据服务条款和信息安全要求,可能存在使用限制。
本地LLM的数据不离开自有环境,更易应用于高保密性业务。但服务器的采购、安装和运维需要自行负责。
哪种方式更合适,取决于数据性质、所需响应速度、成本和运维能力。「先用云端试验,机密数据再转为本地」的分阶段导入也是有效选择。
04
GPU选型不只看数量
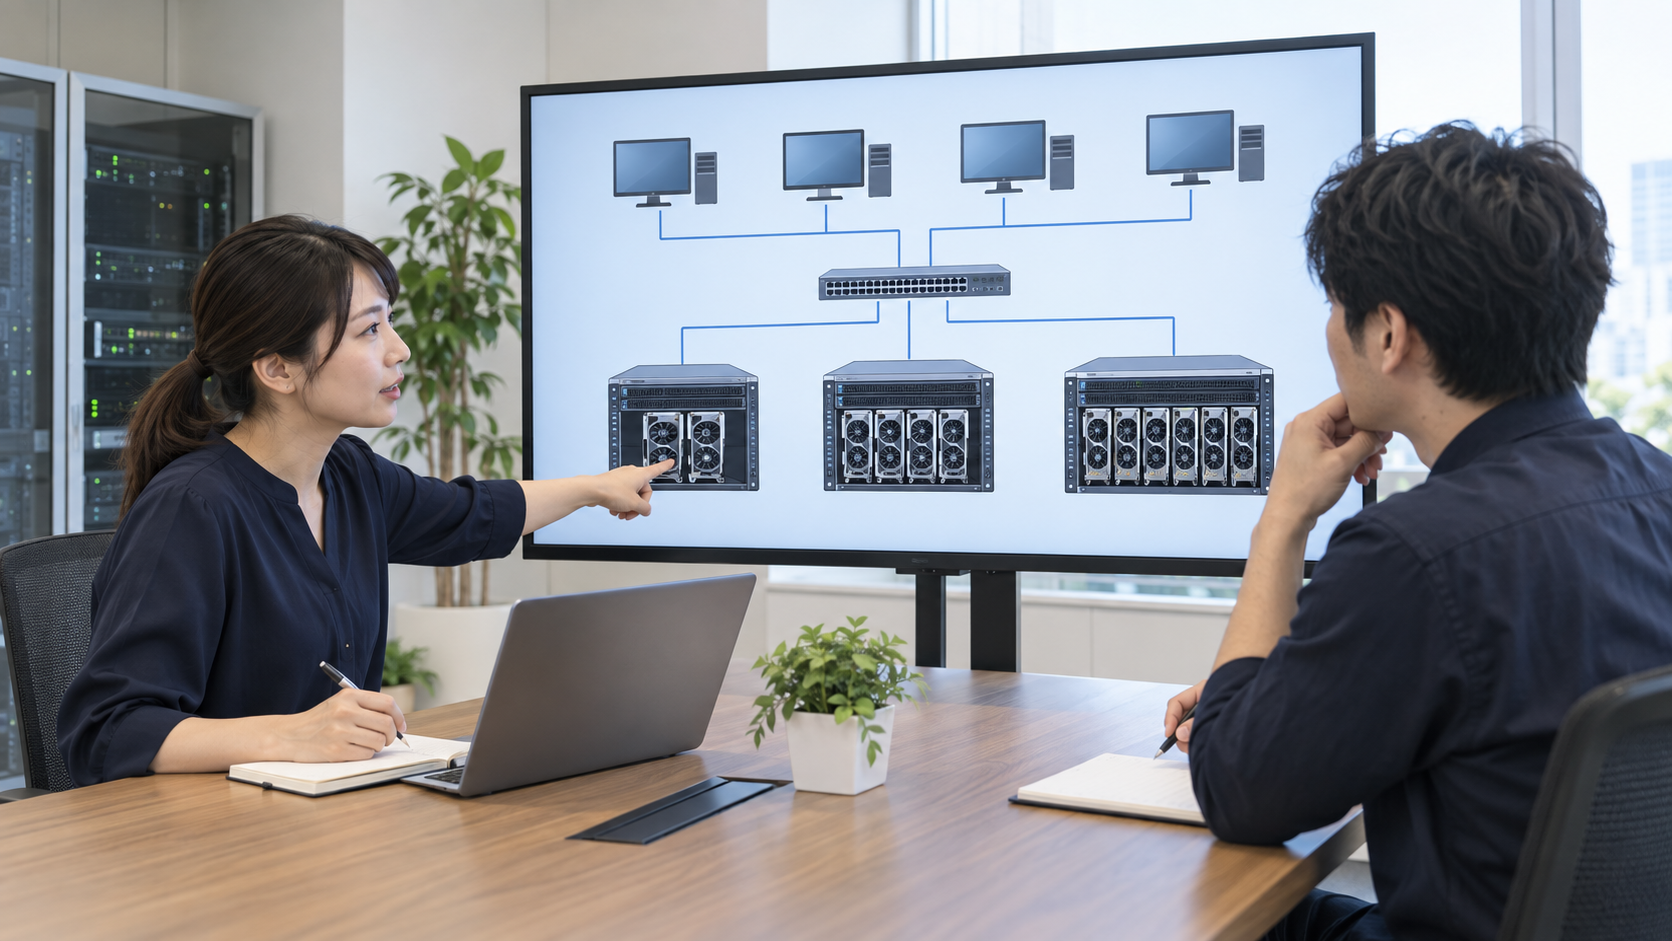
本地LLM的性能不仅取决于GPU数量,还高度依赖单卡显存容量(VRAM)和GPU间的互联带宽。运行大型模型需要将其分布在多张GPU上,GPU间通信速度可能成为瓶颈。
随着并发用户数增加,所需显存和算力也随之增长。「单人推理」与「10人同时推理」所需的配置截然不同。
服务器数量和互联拓扑也因使用场景而异。单台还是多台协同,取决于吞吐量、可用性和预算的平衡。建议先明确预期用途和规模,再评估合适的配置。
05
文档检索不只依赖GPU
利用本地LLM对内部文档进行检索和问答的方法称为「RAG(检索增强生成)」。在LLM生成回答之前,先检索相关文档并作为上下文提供,从而得出有依据的回答。
实现RAG需要文档向量化、索引构建和检索引擎设计。这不仅依赖GPU性能,还涉及存储速度、CPU处理能力和软件架构。
「增加GPU就能实现文档检索」是过于简化的说法。在设计整体系统之前,需要先明确文档类型、数量、更新频率和回答质量要求。
06
本地LLM的局限性与合理预期
对于训练数据中不包含的最新信息或高度专业的领域知识,本地LLM可能生成错误回答(幻觉)。必须设计要求人工核验回答的运营流程。
此外,模型越大并不意味着越适合您的场景。选择适合任务的模型并用实际业务数据进行验证,是提高导入后满意度的关键。
「导入后业务就能自动化」的期望目前过于乐观。建议以「AI辅助、人工判断和确认」的分工为前提来设计业务流程。
07
小规模验证后再确定配置
导入本地LLM无需从一开始就准备大规模配置。建议先选择1至2个典型场景,用小规模配置验证回答质量、响应速度和易用性。
根据验证结果确定所需GPU配置、服务器数量、存储和网络设计,可以减少过度投资和导入后的配置变更。
安装条件(电源、空间、重量、散热)需要与GPU配置同步确认。与其在配置确定后再寻找安装场所,不如先了解安装环境的限制条件,再缩小配置范围,这样能实现更顺畅的导入。
本文以IMMERSIA EDGE为例提供参考信息。内容基于公开资料,但实际性能、配置和安装可行性因使用场景和环境而异。导入前请务必咨询专业人员。
※ 本文图片为AI生成的示意图,不代表实际导入场所、员工、实物产品或已验证的成果。